羊社長です。レシートを読み取って仕訳にしている話の、技術寄りの部分です。
「文字が読めない」で詰まっている方に向けて、実際に測った数字を出します。
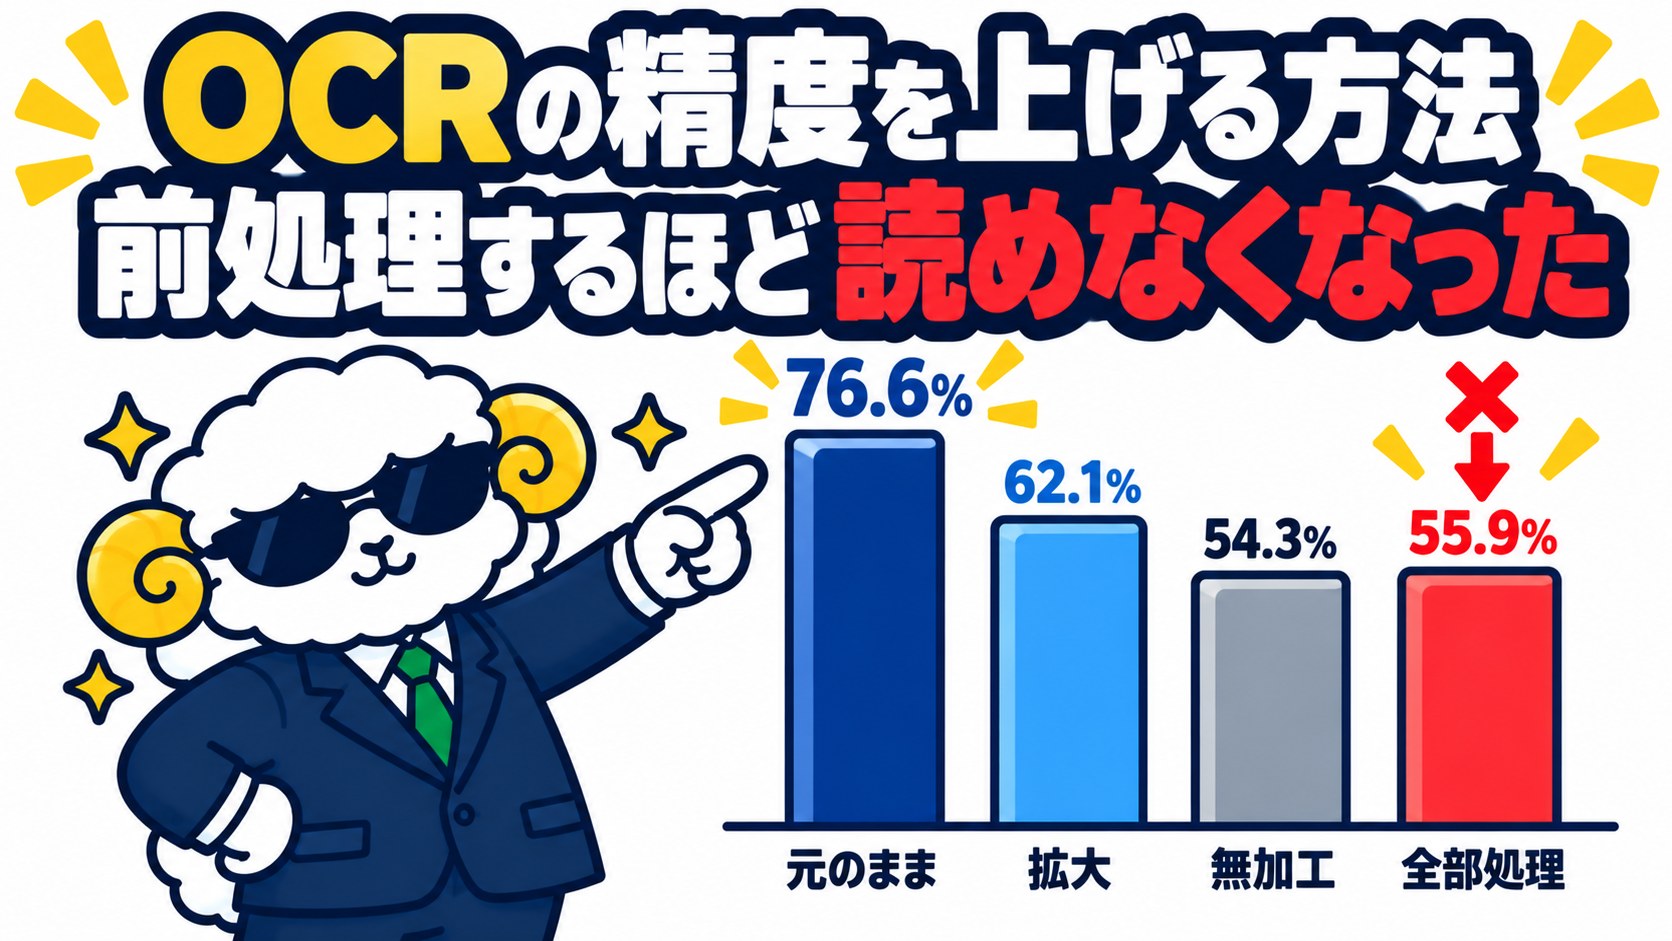
結論を先に書きます
元のPDFを高い解像度で読む       76.6%
画像を3倍に拡大してから読む      62.1%
何もしない                     54.3%
二値化・ノイズ除去まで全部やる    55.9%    ← やるほど悪くなった
同じ1枚の書類を、4通りで読んで一致率を比べた実測です。
「きれいに前処理したほうが読める」と思っていました。逆でした。
まず、tesseractで失敗しました
最初に試したのは tesseract です。無料で、日本語(jpn)にも対応しています。OCRと調べると、だいたい最初に出てきます。
実際の書類でやったら、使い物になりませんでした。
崩れたもの
  ・固有名詞(人の名前・会社名)
  ・電話番号
  ・メールアドレス
一番読んでほしいところが、一番崩れます。本文はそれなりに読めるのに、名前と番号が化ける。経理で使うなら、そこが読めないと意味がありません。
tesseractが悪いという話ではありません。私が扱う書類(日本語・数字・固有名詞が混ざったもの)に合わなかった、というだけです。英文中心なら評価は変わると思います。
Macに最初から入っているもので作りました
結論から言うと、Macには文字を読む仕組みが最初から入っています。写真アプリで画像の中の文字を選択できるのは、これが動いているからです。
Claude Codeに「これを使って、ファイルを読む道具を作って」と頼みました。
できたもの
  コマンド1つで、画像もPDFも読める
  1ページ 0.3〜0.8秒
  課金なし・ネット接続なし(手元で完結する)
  向きが横になっていても、勝手に直して読む
追加でお金はかかっていません。Macに元から入っているものを呼んでいるだけです。
前処理を4通り試しました
ここからが本題です。
OCRがうまくいかないとき、普通は画像をきれいにしてから読ませようとします。白黒にする、ノイズを消す、拡大する。私もそう思って、全部試しました。
同じ書類1ページで比べた結果がこれです。
| やり方 | 一致率 |
|---|---|
| 元のPDFを高い解像度で読む | 76.6% |
| 画像を3倍に拡大してから読む | 62.1% |
| 何も加工しない | 54.3% |
| 白黒化・ノイズ除去まで全部やる | 55.9% |
白黒化とノイズ除去は、何もしないのとほぼ同じでした。手間をかけたぶんが、丸ごと無駄です。
なぜそうなるのか
おそらく、元の画像が持っている情報を、前処理で捨てているからです。
白黒にする    → 薄い文字と背景の差が消える
ノイズを消す  → 細い線や点が、ノイズと一緒に消える
薄い文字・小さい文字ほど、消されます。レシートの金額や、細かい数字は、まさにそこです。
やるべきことは、1つだけでした
元のデータを、高い解像度のまま読ませる。
PDFがあるなら、画像に書き出さずにPDFのまま、解像度を上げて読む。これだけで76.6%です。
① 元がPDFなら     → 解像度を上げて、そのまま読ませる   ★これが一番
② 画像しかないなら  → 拡大だけする(3倍くらい)
③ 白黒化・ノイズ除去 → やらない
「画像に書き出してから読ませる」のが、一番もったいないです。書き出した時点で情報が減っています。
⚠️ 分かったこと
① 手書きは読めません
これは変わりません。印字されたものだけです。手書きの伝票や、手書きのメモは諦めてください。
② 速さを選ぶと、日本語が返ってきません
速く読む設定があったので試したところ、日本語だと何も返ってきませんでした。英数字専用でした。日本語の書類では使えません。
③ 「文字を取る」と「項目に割り振る」は別の作業です
文字を取る         → 手元の仕組みで十分(無料)
どれが日付・金額か   → ここは別の工程
読み取った文字を「これは日付、これは金額、これは店名」と割り振るのは、別の仕事です。文字さえ取れていれば、そこは何とでもなります。まず文字を取るところを安定させてください。
④ Macの話です
この方法はMacに入っている仕組みを使っています。WindowsやLinuxでは、同じことはできません。別の手段を探すことになります。
※【広告】市販の会計ソフトのOCR(まずは無料でお試し【freee会計】 など)は、この前処理を内側でやっています。自分で組むときだけ、ここが効いてきます。
まとめ
- 🔴 前処理をやるほど、読めなくなりました。白黒化・ノイズ除去は逆効果です
- 🔴 一番効いたのは「元のデータを高い解像度のまま読む」こと。76.6%対54.3%
- tesseractでは、固有名詞・電話番号・メールが崩れました(私の書類に合わなかっただけです)
- Macには文字を読む仕組みが最初から入っています。追加の費用はかかりません
- ⚠️ 手書きは読めません
- ⚠️ 速さを優先する設定は、日本語だと何も返しません
- ⚠️ 「文字を取る」と「項目に割り振る」は別の作業です。まず文字を安定させてください
- ⚠️ Macの話です。他のOSでは別の手段が要ります
羊社長が一番無駄にしたのは、画像をきれいにしていた時間でした。
この記事は2026年10月時点の、私自身の環境での実測です。一致率は書類の種類・印字の状態・解像度によって変わります。ソフトウェアの評価は用途や言語によって異なりますので、ご自身の書類で比べてご判断ください。
コメント